事件调查
Cloudflare:新沙箱里,为什么会有别人的旧文件
Cloudflare 给每个容器安排了独立虚拟机,回收的磁盘块却把上一位用户的数据带了进来。一次小写入让旧内容重新可读;修复既要让新分配的空间清零,也要清走已经保留旧内容的磁盘和镜像缓存。
文章导航
创建一个新沙箱,通常是为了得到一台可以放心折腾、用完就丢的电脑。里面可以编译陌生项目、运行代理生成的代码,出了问题也不该碰到其他人的工作。9 月 24 日,Accomplish 研究员 Oren Yomtov 披露,他在 Cloudflare 的沙箱里读到了其他客户留下的文件内容。研究者列出的类型包括 SQLite 数据库、Chromium 配置、.env 和凭据文件,并将使用同一磁盘实现的 Browser Run 列入影响范围。
数据是从新环境自己的磁盘里读出来的。Cloudflare 与研究团队的联合复盘把原因定位到 Containers、Sandboxes 使用的存储池:磁盘块在不同账户之间回收再分配,重新交付前跳过了清零。新盘第一次读出来可以全是零,写入一小段以后,旁边却可能出现旧用户的内容。为什么一次写入会改变未写区域的读取结果?问题出在磁盘空间何时真正分配。
1 新磁盘的空间,要等写入时才分配
先把“磁盘”分成两层。程序看到的是一串可以读取和写入的地址;宿主机还要决定,这些地址对应物理存储的哪一块。薄置备,也就是 thin provisioning,把实际分配推迟到需要写入时。一个看起来很大的新盘,可以暂时只占很少的实际空间。Linux 的 dm-thin 用映射记录把两层地址接起来,多个薄盘可以从同一数据池取得空间。
这种安排把一个安全问题放到了分配时刻:一块空间上次归谁使用,这次交付前有没有处理旧内容?删除旧映射只解决“还属于谁”的问题。数据池如果把同一块实际空间给了下一台盘,留下的字节仍需要被新内容覆盖,或者先行清零。给新盘换名称、换标识、建立新的文件系统,都不能单凭这些动作保证每个底层字节已经改写。
事故中,每个容器运行在独立的 Firecracker 虚拟机内,可写根盘是 /dev/vdc。这里的隔离关系可以与 Firecracker 的设备模型一起理解:虚拟机通过交给它的块设备读写,设备背后的资源由宿主机提供。只要宿主机把带着旧内容的空间映射进这台盘,来宾在自己盘内的读取就能拿到它。这个过程不需要先控制另一台正在运行的虚拟机。
下面用公开的 Linux v6.12 实现解释分配逻辑。它用于核对 dm-thin 的行为,Cloudflare 没有公布事故现场的内核版本;本文也没有在该云服务上执行验证。process_cell() 先查地址映射。在没有映射、也没有外部 origin 数据源的读路径上,provision_block() 直接用零填充返回缓冲区,随后结束读取。物理块还没有分配。
第一次读取拿到的是程序填出的零,尚未接触任何物理块。稍后的写入才会取得真实存储空间,建立映射。旧数据正是在这一步被带进新盘的。
2 写入一小段,整块旧内容有了新主人
研究者使用 Workers Paid 账户启动自己的环境,直接读写 /dev/vdc 的原始字节,并在来宾 ext4 文件系统的空闲区选择对齐位置。残留内容可以不属于当前盘的任何正常文件;只列出当前目录,也就看不到这条读取路径。
Cloudflare 公布的现场参数是每个 thin block 为 64 KiB,存储池启用了 skip_block_zeroing。一次对齐的 4 KiB 写入触发整块分配,新数据覆盖了十六分之一,剩余 60 KiB 可能仍是上一个使用者的内容。这里的 60 KiB 是未覆盖空间的大小,实际能恢复什么还取决于那块空间的历史。
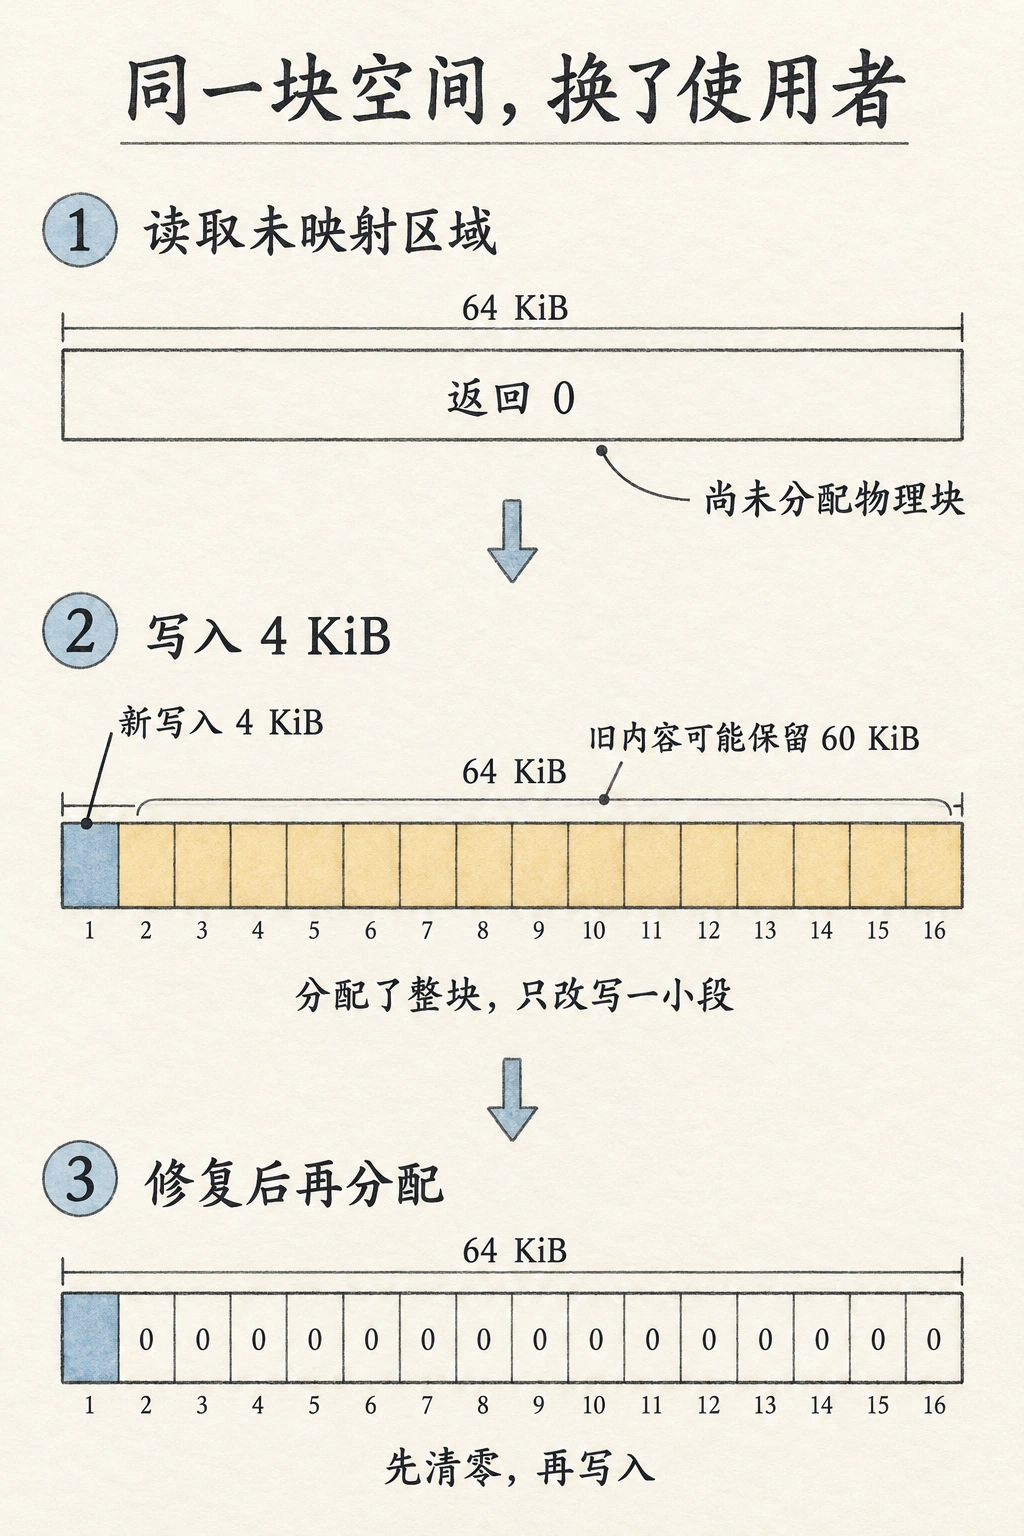
Linux v6.12 的默认设置会清零新块,解析这个选项后则把 zero_new_blocks 设为 false。在 schedule_zero() 中,关闭清零会直接进入准备好的映射处理;启用时,部分写需要先完成清零。
接着,process_prepared_mapping() 把新关系写入映射树。此后读取已有映射会直达对应物理块,已经不走前面的“无映射就返回零”分支。这就把完整过程接上了:第一次读零,写入使真实空间归入当前盘,第二次读取能看见该空间尚未覆盖的部分。
整块覆盖是一个容易误导测试的对照。如果测试先向全部 64 KiB 写入新数据,再读回来,当然只能看见新内容。内核在启用清零时也允许完整覆盖跳过额外擦零,因为这次写入本身将替换整个块。要区分这两种情况,测试输入必须留下未写区域;只验证“我写的内容能读回来”,漏掉的正是其他区域里多出来的东西。
研究团队用 ext4 的目录校验机制追查残留的来源。ext4 文档说明,目录块校验涉及文件系统 UUID、inode 编号、inode generation 和目录内容。带入自己的文件系统身份计算后,5,614 个可测试目录块没有一个匹配;自己创建、删除的 162 个对照块则全部匹配。两组结果支持了同一个判断:这些残留来自别的文件系统。
3 清零开关修好了,已有磁盘还留着旧状态
将清零重新打开以后,再走一遍刚才的分配,未写部分就会被清掉。不过,已经映射的块仍沿原来的关系读取。设想一台盘在修复前就取得了那块带残留的空间,修复后只继续读它:整个过程没有发生新分配,新的清零条件也就没有机会参与。
快照又让这些旧映射活得更久。dm-thin 的内部快照起初与原盘共享数据块;源码对写时复制的说明把这个关系写得很清楚:两棵映射树可以指向相同的数据,之后写入再分开。共享块的读取仍能直接使用已有物理地址。因此,修复后创建一个新实例,若继承了修复前的快照,也可能继承那份已经建立的映射。
本次实际需要清理的还包括宿主机上缓存的 OCI 镜像层所对应的预制 dm-thin 快照。镜像层本来用于复用准备工作,却同时保留了当时的磁盘状态。Cloudflare 的处置分成两个阶段:9 月 7 日 06:13 UTC 完成清零配置推广,9 月 19 日 15:03 UTC 完成修复前缓存的清理;期间退役旧容器磁盘、重启虚拟机并清理主机镜像缓存。这两个时间回答的是不同问题:何时不再产生新的脏分配,以及何时清走了仍会继承的旧状态。
自建平台可以据此设计隔离测试:用自有标记数据,分别检查未映射读取、释放后重新分配的部分写、整块覆盖,以及从修复前快照创建新盘。前三条区分分配和覆盖,最后一条检查旧状态是否继续传播。每次记录映射,确认实际复用了带标记的物理块;分到另一块干净空间,测不出回收路径的问题。这组测试建议尚未执行。
4 平台已经修复,用户还需要知道什么
截至 10 月 2 日核对,Cloudflare 的公开结论是修复和清理已完成,客户无需改变配置或采取额外操作。它在保留的磁盘 I/O 遥测中回查,识别出的相关行为属于获授权的研究与工程验证,没有发现其他恶意利用迹象。公开材料没有给出完整暴露起止时间或逐客户泄露名单;一家公司是否有具体文件被读过,仍需供应商掌握的记录才能回答。
读取机会受同一宿主机上的回收空间限制,调度由平台决定,研究者无法指定客户或正在使用的磁盘。对使用者而言,这让影响判断需要落到实际工作负载:当时哪些任务曾把数据库、浏览器状态或秘密写进受影响的环境?如果供应商通知或自身记录进一步指向某个凭据,再围绕它的权限、有效期和使用记录撤销、更换与追查。
代理工作区还可以减少落盘的秘密。只用于调用外部 API 的凭据,可以留在工作区外,由受控服务代发请求;必须交给任务的凭据,则限制可访问对象和存活时间。这样能减少下次残留泄露的内容。已经发生的读取仍按前述线索调查,存储池的清零与旧状态清理仍由平台完成。
评估沙箱时,值得追问任务结束后的状态去向。虚拟机进程会退出,物理块、镜像缓存和快照可能继续存在,交给下一位用户。检查也应跟着走到这次交接,而不能停在新实例的第一次空盘读取。